8 min de leitura
Porque é que o modelo precisa deste dado?
Num projeto de AI com dados sensíveis, a pergunta que desenha a arquitetura é porque é que o modelo precisa de receber cada dado. Fronteiras de privacidade, menor privilégio e a diferença entre pseudonimizar e anonimizar, com três casos reais.
O primeiro pedido concreto de um cliente recente, uma family office nos Estados Unidos que gere o património de um pequeno grupo de famílias, foi um anonimizador. Os relatórios automáticos e os assistentes internos vinham depois. A equipa já usava Claude no dia a dia, mas a caixa de correio do sócio principal (clientes, fornecedores, colegas e amigos, tudo no mesmo endereço) estava cheia de nomes e montantes que ninguém queria ver sair do escritório. A ordem estava certa.
Num projeto de inteligência artificial (AI) com dados sensíveis, a decisão mais importante acontece antes da escolha do modelo: definir onde os dados identificáveis podem existir, que sistemas lhes podem tocar e em que ponto deixam de ser sensíveis. A pergunta que organiza tudo isto cabe numa linha. Porque é que o modelo precisa de receber este dado?
O que é uma fronteira de privacidade?
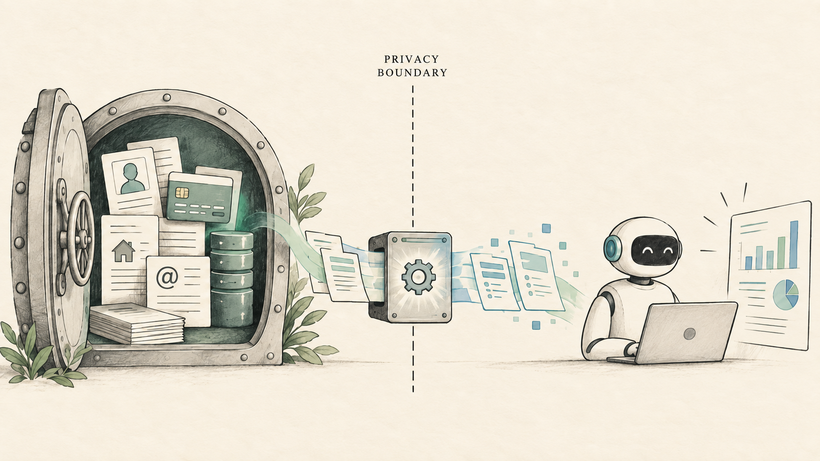
Uma fronteira de privacidade é o limite, desenhado na arquitetura, entre os sistemas onde os dados pessoais podem existir e os sistemas que só recebem dados já tratados. Os documentos originais entram num ambiente de processamento seguro. Lá dentro, um passo identifica e substitui o que aponta para pessoas (nomes, moradas, números de contribuinte, referências a colaboradores), um segundo passo valida o resultado, e só o que passa na validação atravessa a fronteira para os modelos que os vão classificar ou resumir. O modelo do outro lado faz o trabalho todo sem ter tido acesso aos originais.
Dois termos costumam andar juntos e fazem coisas diferentes. Uma sandbox é um ambiente isolado onde um programa, um agente ou um modelo corre com acesso restrito a ficheiros, rede, interfaces de programação (API) e permissões; protege o resto dos sistemas daquilo que corre lá dentro. Em maio, a OpenAI descreveu como construiu a sandbox do Codex no Windows, o seu agente de programação: o agente só escreve na pasta de trabalho, a saída para a internet fica bloqueada até alguém a aprovar, e cada processo que ele lança herda as mesmas restrições. Um ambiente de processamento seguro faz o movimento inverso, porque existe para que a informação sensível seja tratada sem atravessar uma fronteira definida à partida. A sandbox protege o mundo do programa. O ambiente seguro protege os dados do mundo. A peça que o torna possível é o egress restrito, a limitação das ligações de saída: o processo que anonimiza recebe um ficheiro, devolve um ficheiro e não tem por onde abrir uma ligação à internet a meio do caminho.
Porque é que a promessa do fornecedor não chega?
A segurança por arquitetura reduz a quantidade de confiança de que um sistema precisa para ser seguro. A pergunta mais frequente sobre ferramentas de AI é se o fornecedor treina modelos com os dados dos clientes, e a resposta está no contrato. Mesmo a melhor resposta continua a ser uma promessa: o sistema recebe tudo e alguém garante que não fará nada de errado com isso. A alternativa é desenhar o sistema de modo a que certos dados nunca lhe cheguem. O dado mais seguro é aquele que o modelo nunca recebe.
O Regulamento Geral sobre a Proteção de Dados (RGPD) já pede isto há oito anos, com o nome de minimização: os dados tratados devem ser "adequados, pertinentes e limitados ao que é necessário" para a finalidade (artigo 5.º). O princípio do menor privilégio aplica a mesma lógica às permissões. Cada utilizador, serviço ou agente recebe o acesso mínimo necessário para a sua função (é, quase palavra por palavra, a definição do glossário do National Institute of Standards and Technology, o organismo de normas dos Estados Unidos). Um agente que consulta uma base de produtos dispensa a capacidade de enviar emails. Um processo que anonimiza documentos dispensa o browser.
Com agentes que executam ações, a conta muda de escala. Um agente com acesso ao email que lê um documento com uma instrução escondida (a chamada injeção de instruções) pode ser levado a enviar dados para fora, e a única defesa independente do comportamento do modelo é ele não ter essa ferramenta. Nenhum destes princípios nasceu com a AI. Os agentes só tornaram mais cara a sua ausência.
Qual é a diferença entre pseudonimizar e anonimizar?
Pseudonimizar substitui identificadores e guarda, noutro sítio, a chave que permite voltar atrás; anonimizar procura tornar a reidentificação razoavelmente impossível. A diferença tem consequências legais: dados pseudonimizados continuam a ser dados pessoais para quem tem a chave, e o RGPD aplica-se por inteiro, enquanto dados verdadeiramente anónimos ficam fora do regulamento. O exemplo mais familiar é o do hospital que envia análises para um laboratório externo com um código de amostra em vez do nome do doente. O laboratório faz o trabalho todo sem saber quem é a pessoa, e o hospital consegue sempre juntar o resultado à ficha certa.
Apagar nomes raramente chega para anonimizar. Em 2000, Latanya Sweeney mostrou que 87% da população dos Estados Unidos era provavelmente única com apenas três campos: código postal de cinco dígitos, sexo e data de nascimento. Em Portugal, o código postal de sete dígitos chega muitas vezes ao troço de rua. Um cargo, uma localidade e uma idade bastam para apontar para a única diretora financeira de uma empresa numa vila.
O tema está a mexer agora. A 4 de setembro de 2025, o Tribunal de Justiça da União Europeia decidiu, no processo C-413/23 P, que dados pseudonimizados podem deixar de ser pessoais para um destinatário sem meios razoáveis de reidentificar as pessoas, sem deixarem de o ser para quem guarda a chave (e sem dispensar essa entidade de informar os titulares sobre quem recebe os dados). A 8 de julho de 2026, o Comité Europeu para a Proteção de Dados (CEPD) adotou orientações sobre anonimização que integram esse acórdão e propõem três testes: não ser possível isolar o registo de uma pessoa, ligá-lo a outras fontes ou inferir algo sobre ela. A consulta pública está aberta até 30 de outubro, portanto o critério final ainda pode mudar.
A leitura prática é a mesma em qualquer versão. Um bom pipeline olha para combinações e contexto, e a validação depois da transformação vale tanto quanto a transformação. A deteção automática falha em sítios previsíveis: apelidos que são palavras comuns, alcunhas, assinaturas de email, PDF digitalizados. Uma pessoa a rever amostras continua a fazer parte do processo.
Três fronteiras desenhadas na prática
Na family office, o desenho ficou em três zonas. A primeira trabalha só com informação pública, como notícias e alertas sobre potenciais clientes. A segunda faz análise sobre dados pseudonimizados, com os clientes trocados pelos nomes de código que a equipa já usava internamente. Ambas passam o mesmo teste: nada do que lá está causaria dano se aparecesse amanhã na primeira página de um jornal financeiro. A terceira guarda os dados identificados dentro do Microsoft 365 que a empresa já tinha, e a subscrição de Claude nunca recebe o conector da Microsoft. O cenário que orientou o desenho foi uma fuga ao estilo dos Panama Papers: clientes que nada fizeram de errado e uma empresa que simplesmente não quer os nomes deles em público. O pseudonimizador começa por um dicionário das entidades conhecidas (pessoas, moradas, sociedades e trusts) antes de qualquer varrimento genérico, porque, para um punhado de famílias, a lista do que proteger é conhecida e curta.
Neste blog, dei a um agente as chaves para publicar. A interface que ele usa tem regras próprias: tudo o que cria nasce como rascunho, só pode apagar rascunhos que nunca foram publicados, trabalha com um utilizador dedicado e um token guardado numa variável de ambiente, e está limitado a 120 pedidos por minuto. Publicar continua a ser um clique meu.
O ROMEO, o assistente deste site, lê apenas conteúdo publicado, através de um token só de leitura, e vive numa base de dados separada da do site. As conversas são anónimas, sem endereço IP (Internet Protocol), e apagadas ao fim de 30 dias. A pergunta segue para o fornecedor do modelo, fora da União Europeia, e a política de privacidade diz isso mesmo.
Por onde começa uma PME?
Uma pequena ou média empresa (PME) começa pela lista de campos, muito antes de qualquer infraestrutura. Pegue no processo que quer entregar à AI, escreva os campos de dados que ele tocaria e faça a pergunta a cada um. O que não tiver resposta fica do lado de dentro da fronteira ou é substituído antes de sair. Depois, dê a cada agente uma identidade própria, com as permissões mínimas e um registo de auditoria do que fez, e deixe as ações irreversíveis (enviar, pagar, apagar, publicar) nas mãos de uma pessoa. Estas escolhas cabem num quadro branco e aguentam uma conversa com o encarregado de proteção de dados.
Uma demonstração de AI que funciona faz-se numa tarde. Uma solução que uma empresa aceite pôr ao lado dos seus dados mais importantes leva bastante mais, e quase todo esse tempo vai para decidir o que fica do lado de dentro. Quem, na sua empresa, já fez essa lista?