Atualizado a 8 min de leitura
O que é o Claude, e que modelo deves escolher?
Dois modelos novos numa semana, e o menu do Claude voltou a mudar. Os números de versão passam; os quatro degraus ficam. Um guia para principiantes escolherem o modelo pela tarefa.
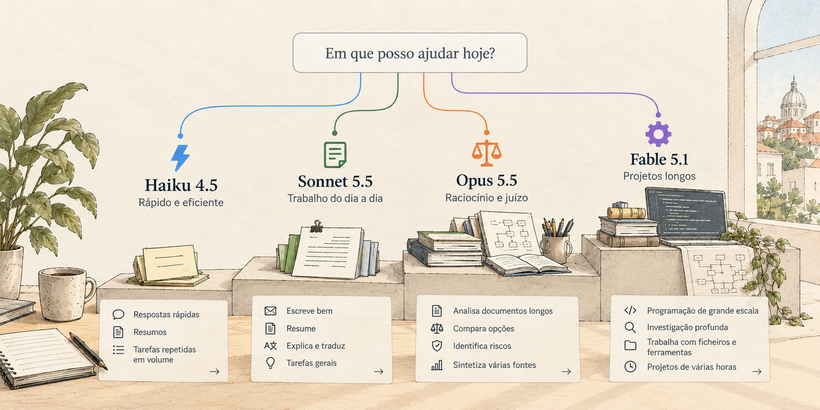
A 22 de setembro, a Anthropic lançou o Opus 5.5. Seis dias depois chegou o Sonnet 5.5. Quem abriu o Claude esta semana encontrou um menu com números diferentes dos da semana anterior, e a pergunta que qualquer principiante faz (qual escolho?) ficou um pouco mais difícil de responder.
A resposta curta é que os números importam pouco. O Claude tem quatro degraus, que se mantêm de versão para versão: um rápido, um para o dia a dia, um para trabalho que pede juízo e um para projetos longos. Escolhe-se o degrau pela tarefa, e a versão é a que estiver no menu nesse dia.
O que é o Claude?
O Claude é o assistente de inteligência artificial (AI) da Anthropic, uma empresa de São Francisco fundada em 2021 por antigos investigadores da OpenAI. Usa-se como uma conversa escrita: fazes uma pergunta, colas um documento ou uma imagem, e ele responde. Está em claude.ai no browser, em apps para computador e telemóvel e, para quem programa, numa interface de programação (API) que deixa outros programas usá-lo sem passar pela app. Chegou à União Europeia (UE) em maio de 2024.
Por trás da app há uma família de modelos, e é o modelo que gera cada resposta. Pensa na app como um escritório e nos modelos como as pessoas que lá trabalham, cada uma com o seu ritmo e o seu preço. O menu por baixo da caixa de texto serve para escolher com quem falas.
Quais são os modelos do Claude?
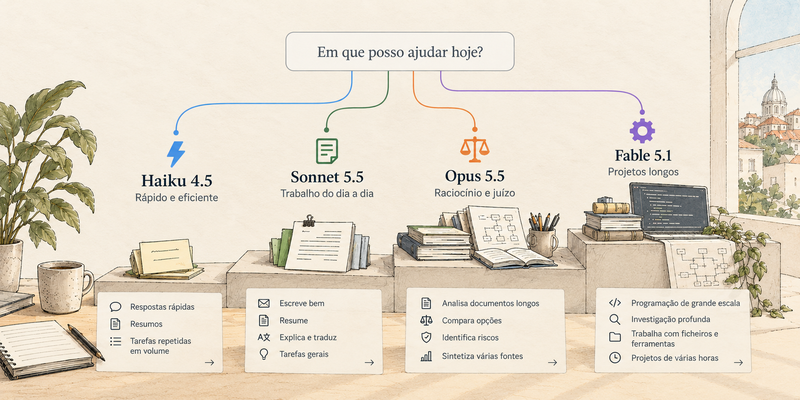
Hoje são quatro, segundo a página de modelos da Anthropic. O Haiku 4.5 é o rápido: respostas curtas, resumos, tarefas repetidas em volume, quando a pressa conta mais do que a profundidade. O Sonnet 5.5 é o do dia a dia, escreve, resume, explica e traduz bem e depressa, e é com ele que a maior parte das pessoas devia começar. O Opus 5.5 pensa com mais cuidado e ganha quando há uma decisão com riscos, um documento longo que tem de estar certo ou várias fontes para cruzar. O Fable 5.1, no topo, existe para projetos de horas em que o Claude trabalha sozinho, como programação de grande dimensão ou investigação longa. (Há ainda um quinto nome, o Mythos, que é o mesmo modelo do Fable com salvaguardas mais permissivas e só está aberto a profissionais verificados de cibersegurança e de ciências da vida. Para quem está a começar, é uma curiosidade.)
A linha que separa o Sonnet do Opus está escrita pela própria Anthropic. No anúncio do Sonnet 5.5, a empresa diz que ele fica a dois pontos do Opus 5.5 num teste de trabalho real, o GDPval-AA, e acrescenta que o Opus continua claramente mais forte em trabalho complexo e aberto, que pede juízo durante muito tempo. Para escrever um email, a diferença quase não se vê. Para decidir entre três fornecedores, vê-se.
Os números de versão contam uma história que ao principiante interessa pouco. O Sonnet 5.5 substituiu o Sonnet 5 pelo mesmo preço e, segundo a Anthropic, gasta menos por tarefa. Quando sair um Sonnet 6, o conselho deste artigo fica igual.
Existe um Claude Haiku 5?
Não. A geração 5 do Claude saiu com o Opus e o Sonnet e saltou o Haiku, por isso o Haiku mais recente continua a ser o 4.5, de outubro de 2025. O próximo já está anunciado: no lançamento do Sonnet 5.5, a 28 de setembro, a Anthropic escreveu que o Haiku 5.5 chega "nas próximas semanas", pensado para trabalho em grande volume e com custo baixo. Até lá, o degrau rápido é o Haiku 4.5, e o resto deste artigo não muda.
Como escolho o modelo certo para cada tarefa?
Olha para a tarefa e faz três perguntas, por esta ordem.
A tarefa é curta e tem uma resposta clara? Resumir um email, reescrever um parágrafo, traduzir, explicar um termo, tirar os dados de uma fatura. Sonnet. Se for para repetir centenas de vezes por dia através da API, Haiku.
A tarefa pede juízo? Comparar três propostas de fornecedores e dizer qual escolher, ler um contrato de doze páginas à procura de riscos, montar um plano a partir de notas soltas de uma reunião. Aqui o Opus compensa, porque uma resposta errada custa mais do que a espera.
A tarefa é um projeto de horas, com o Claude a trabalhar sozinho, a abrir ficheiros e a voltar atrás quando se engana? Fable, e só se o Opus não chegar. Para quem está a começar, é raro ser o caso.
Ao lado do modelo há um segundo controlo, o esforço, que regula quanto trabalho o Claude põe em cada resposta. Mais esforço dá respostas mais completas e mais lentas, e gasta mais depressa os limites do plano. O valor que vem marcado por omissão serve para quase tudo.
Quanto custa usar o Claude em Portugal?
Começar custa zero. O plano gratuito dá acesso ao Sonnet e ao Haiku, com pesquisa na web, criação de ficheiros e memória, e chega para perceber se o Claude te serve. O Pro custa 20 dólares por mês antes de impostos (17 dólares por mês com pagamento anual), à volta de 18 € mais o imposto sobre o valor acrescentado (IVA), e junta o Opus, o Fable, os Projetos e o Claude Code. Os planos Max, a partir de 100 dólares por mês, dão cinco ou vinte vezes o uso do Pro e são para quem passa o dia a trabalhar com ele. As empresas têm o plano Team, pago por lugar, com faturação central e controlo de administrador.
Nenhum plano diz quantas mensagens cabem, e esta é a crítica mais repetida ao Claude. Os limites contam-se em janelas de cinco horas e por semana, e os modelos maiores gastam-nos mais depressa; o guia da própria Anthropic pede que não se use um modelo grande numa tarefa simples precisamente por isso. Em janeiro, programadores queixaram-se de limites que se esgotavam em minutos, e a Anthropic atribuiu-o ao fim de um bónus de fim de ano (The Register). Na prática: fica uma semana no gratuito. Se bateres no limite, ou se as respostas te parecerem curtas nas tarefas que pedem juízo, passa ao Pro e repete-as no Opus.
Uma nota antes de colares documentos. Nas contas pessoais (gratuita, Pro e Max), as conversas só entram no treino dos modelos se ativares a opção Model Improvement nas definições de privacidade, segundo o centro de privacidade da Anthropic, e as conversas em modo incógnito nunca entram. Dados de clientes pedem outro cuidado, e escrevi sobre isso em Porque é que o modelo precisa deste dado?
Que modelo usa o assistente deste site?
O ROMEO, o gato no canto deste site, responde a perguntas sobre o que aqui está publicado, e responde com o Opus. Quando o montei, o Sonnet teria chegado para a maior parte das perguntas e custava bastante menos. Escolhi o Opus porque o ROMEO fala em meu nome, e uma resposta errada sobre o que faço custa-me mais do que a diferença na fatura da API.
O custo ficou fechado por outro lado. Cada resposta tem um máximo de 800 tokens (um token é, grosso modo, três quartos de uma palavra), há um teto diário de perguntas para o site inteiro, e a conta da API funciona com créditos pagos à cabeça, que servem de limite de gasto. Quando o ROMEO não encontra nada no site que responda à pergunta, nem chega a chamar o modelo: devolve uma mensagem fixa. O pior dia possível tem um valor conhecido antes de acontecer.
Com o Sonnet 5.5 a dois pontos do Opus, a troca merece um teste. O teste certo usa as perguntas de verificação que o ROMEO já tem, porque o que interessa é como cada modelo responde às perguntas deste site.
Por onde começar?
Cria conta em claude.ai e passa uma semana no Sonnet com trabalho a sério: um email difícil, um relatório para resumir, uma decisão que andas a adiar. Guarda as respostas que te pareceram fracas. Se passares ao Pro, repete essas no Opus e compara (a comparação ensina mais sobre os degraus do que qualquer tabela). Para tirar mais das decisões, o AI Council é uma técnica simples que funciona em qualquer modelo.
Daqui a três meses, o menu vai ter outros números. Das tarefas que fazes hoje, quais é que ainda vão precisar do degrau de cima?